Résumé
Passage d’un accès réservé au terminal, où 86 % des données publiées restaient inconsultées, à une interface graphique qui relie les données par leur provenance, avec 94 % de données consultées.
Passage d’un accès réservé au terminal, où 86 % des données publiées restaient inconsultées, à une interface graphique qui relie les données par leur provenance, avec 94 % de données consultées.
Passage d’un accès réservé au terminal, où 86 % des données publiées restaient inconsultées, à une interface graphique qui relie les données par leur provenance, avec 94 % de données consultées.
Le prototype d’abord
Je pousse en permanence les parties prenantes à créer un prototype ou une preuve de concept avant tout travail de design pur, pour tester la proposition de valeur et le business plan.
Blue Brain Project, EPFL
2022 – 2024
Product Design Lead et ingénieur frontend
L’équipe NISE, 3 ingénieurs backend, et les équipes de neuroinformatique computationnelle et de HPC
Données consultées de 14 % à 94 %
86 % des données publiées n’étaient jamais consultées, car elles n’étaient accessibles que par le terminal et un SDK, alors que les scientifiques voulaient surtout voir les liens entre les données.
Refuser de réduire le produit à une recherche de bibliothèque avec des points d’accès API, appuyer ce refus sur cinq ans de données d’usage et sur la recherche qualitative, puis prouver la faisabilité par un test sur un circuit de 20 neurones.
Données consultées de 14 % à 94 %, avec plus de 2 600 chercheurs actifs par mois.
01
Des données publiées que presque personne ne consulte
Au Blue Brain Project, un premier diagnostic d’usage montre que 86 % des données publiées de Fusion ne sont jamais consultées. Elles ne s’atteignent que par un SDK ou le terminal, alors que les scientifiques veulent voir les liens entre les données. En interne, certains veulent réduire le produit à une recherche et à des points d’accès API. La plateforme complète se heurte à trois objections : le coût, une priorité jugée plus basse et la qualité des données.
02
Ce que j’ai imposé, négocié ou refusé
Certains voulaient réduire le produit à une recherche de bibliothèque et à des points d’accès API à copier dans un terminal. J’ai défendu une vraie plateforme, pour structurer, annoter, relier et partager les données. En deux à trois réunions, j’ai appuyé ma position sur les entretiens avec les scientifiques et sur cinq ans de requêtes API, qui montraient que le terminal était rarement utilisé. J’ai aussi refusé de lancer des simulations depuis l’application web : cela demandait une application à part entière, avec ses paramètres et une validation des données avant chaque simulation.
03
De listes de projets sans repères à une exploration par type de données et par provenance
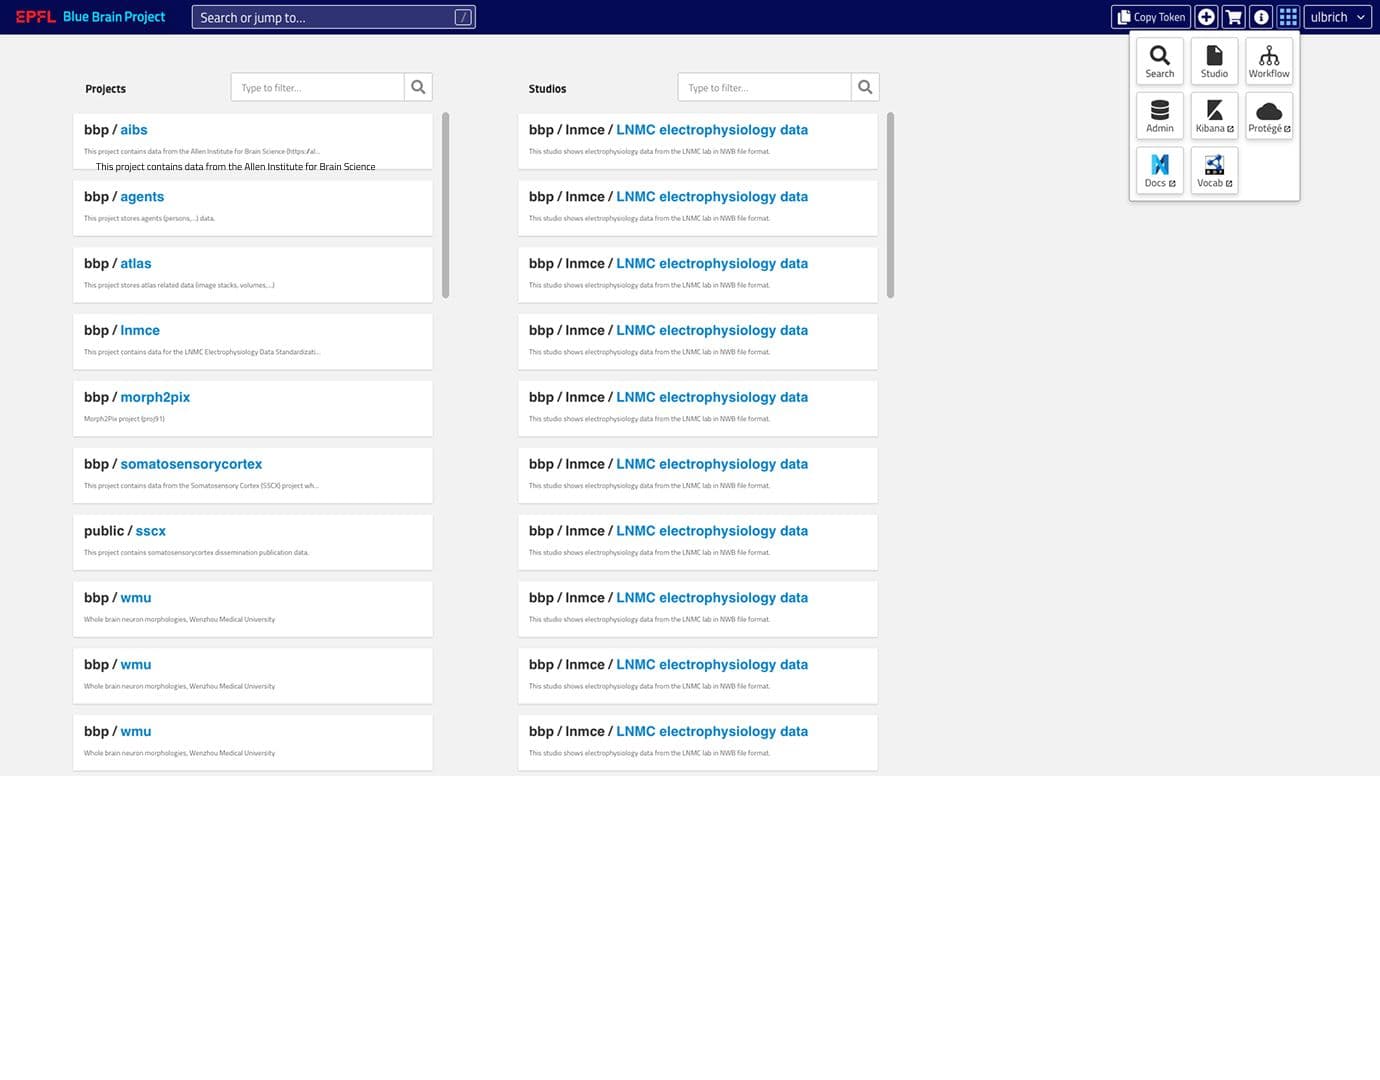
Les deux longues listes de projets et d’études, où les entrées se répètent à l’identique.
Le menu d’outils éparpillés (Search, Studio, Workflow, Admin, Kibana…).
La recherche par type de données (morphologies, électrophysiologies, simulations…), avec le nombre de jeux de données.
Les éléments épinglés.
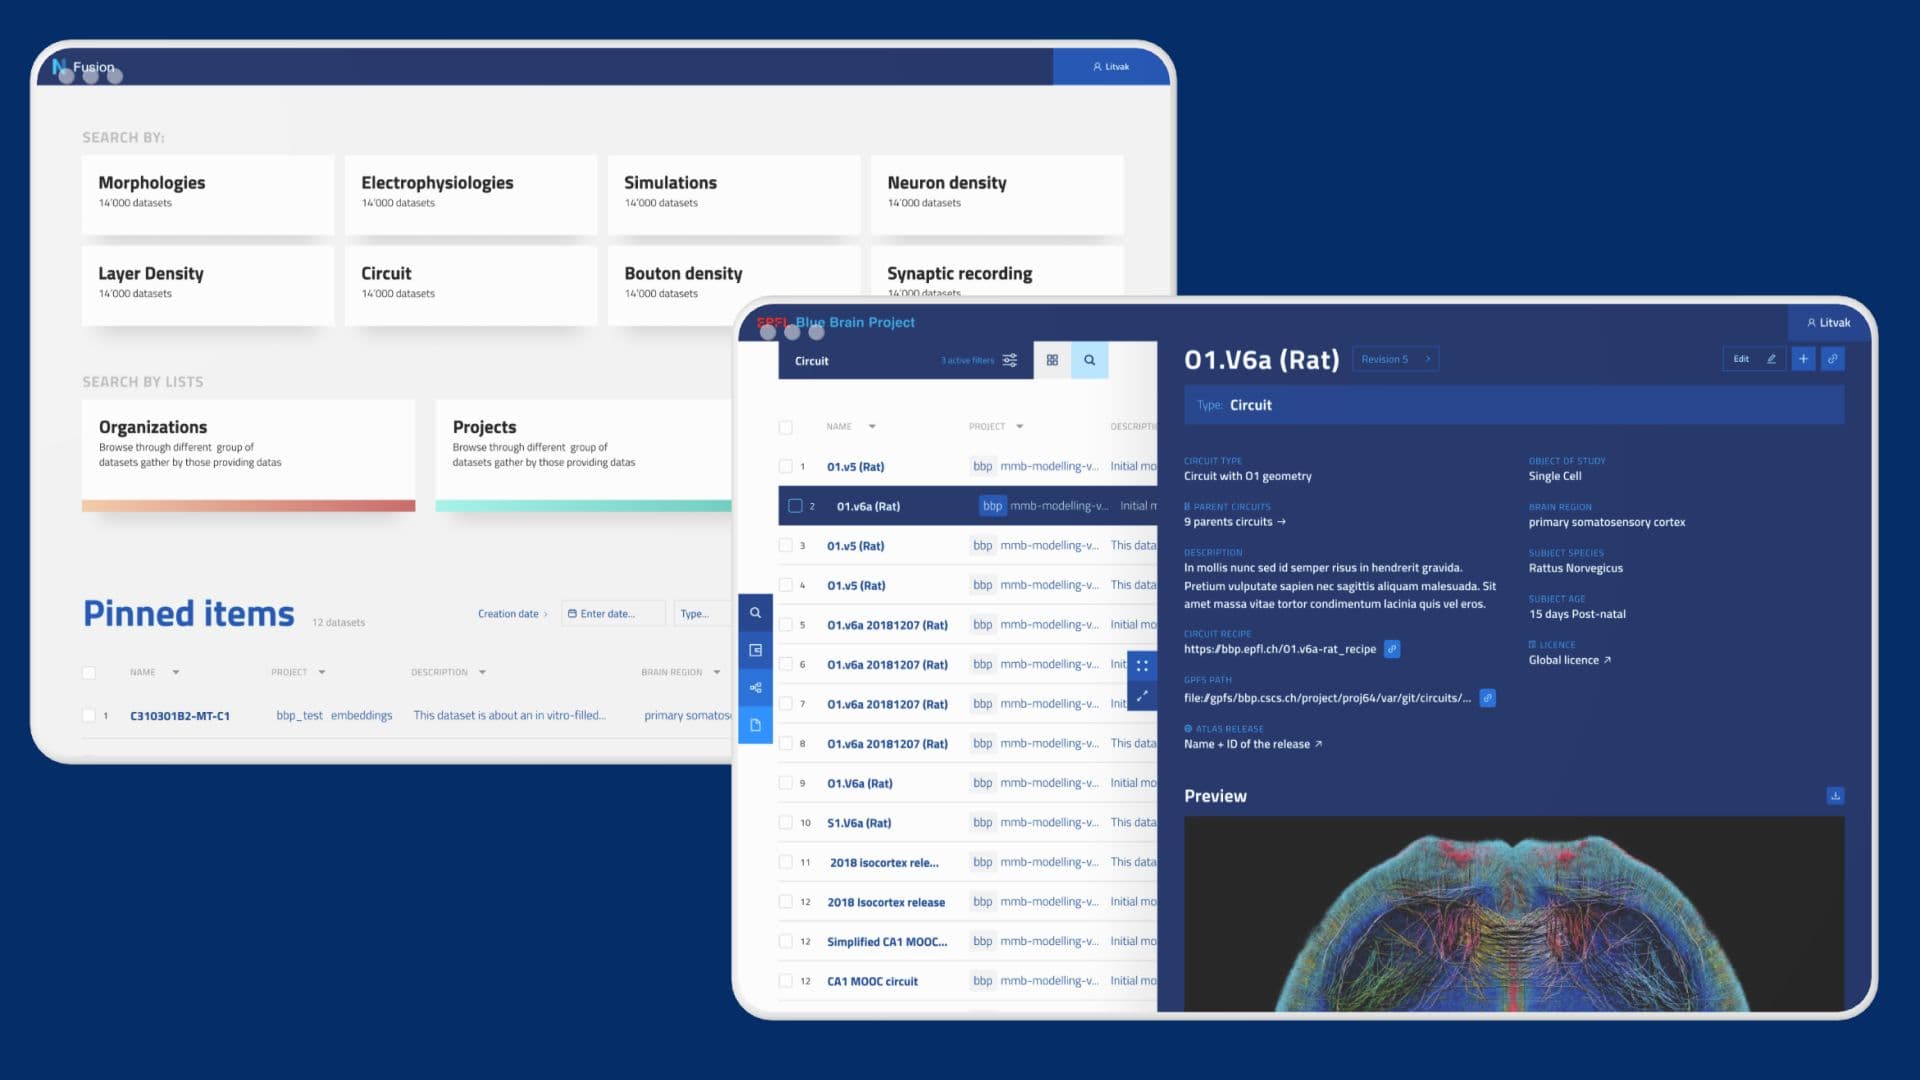
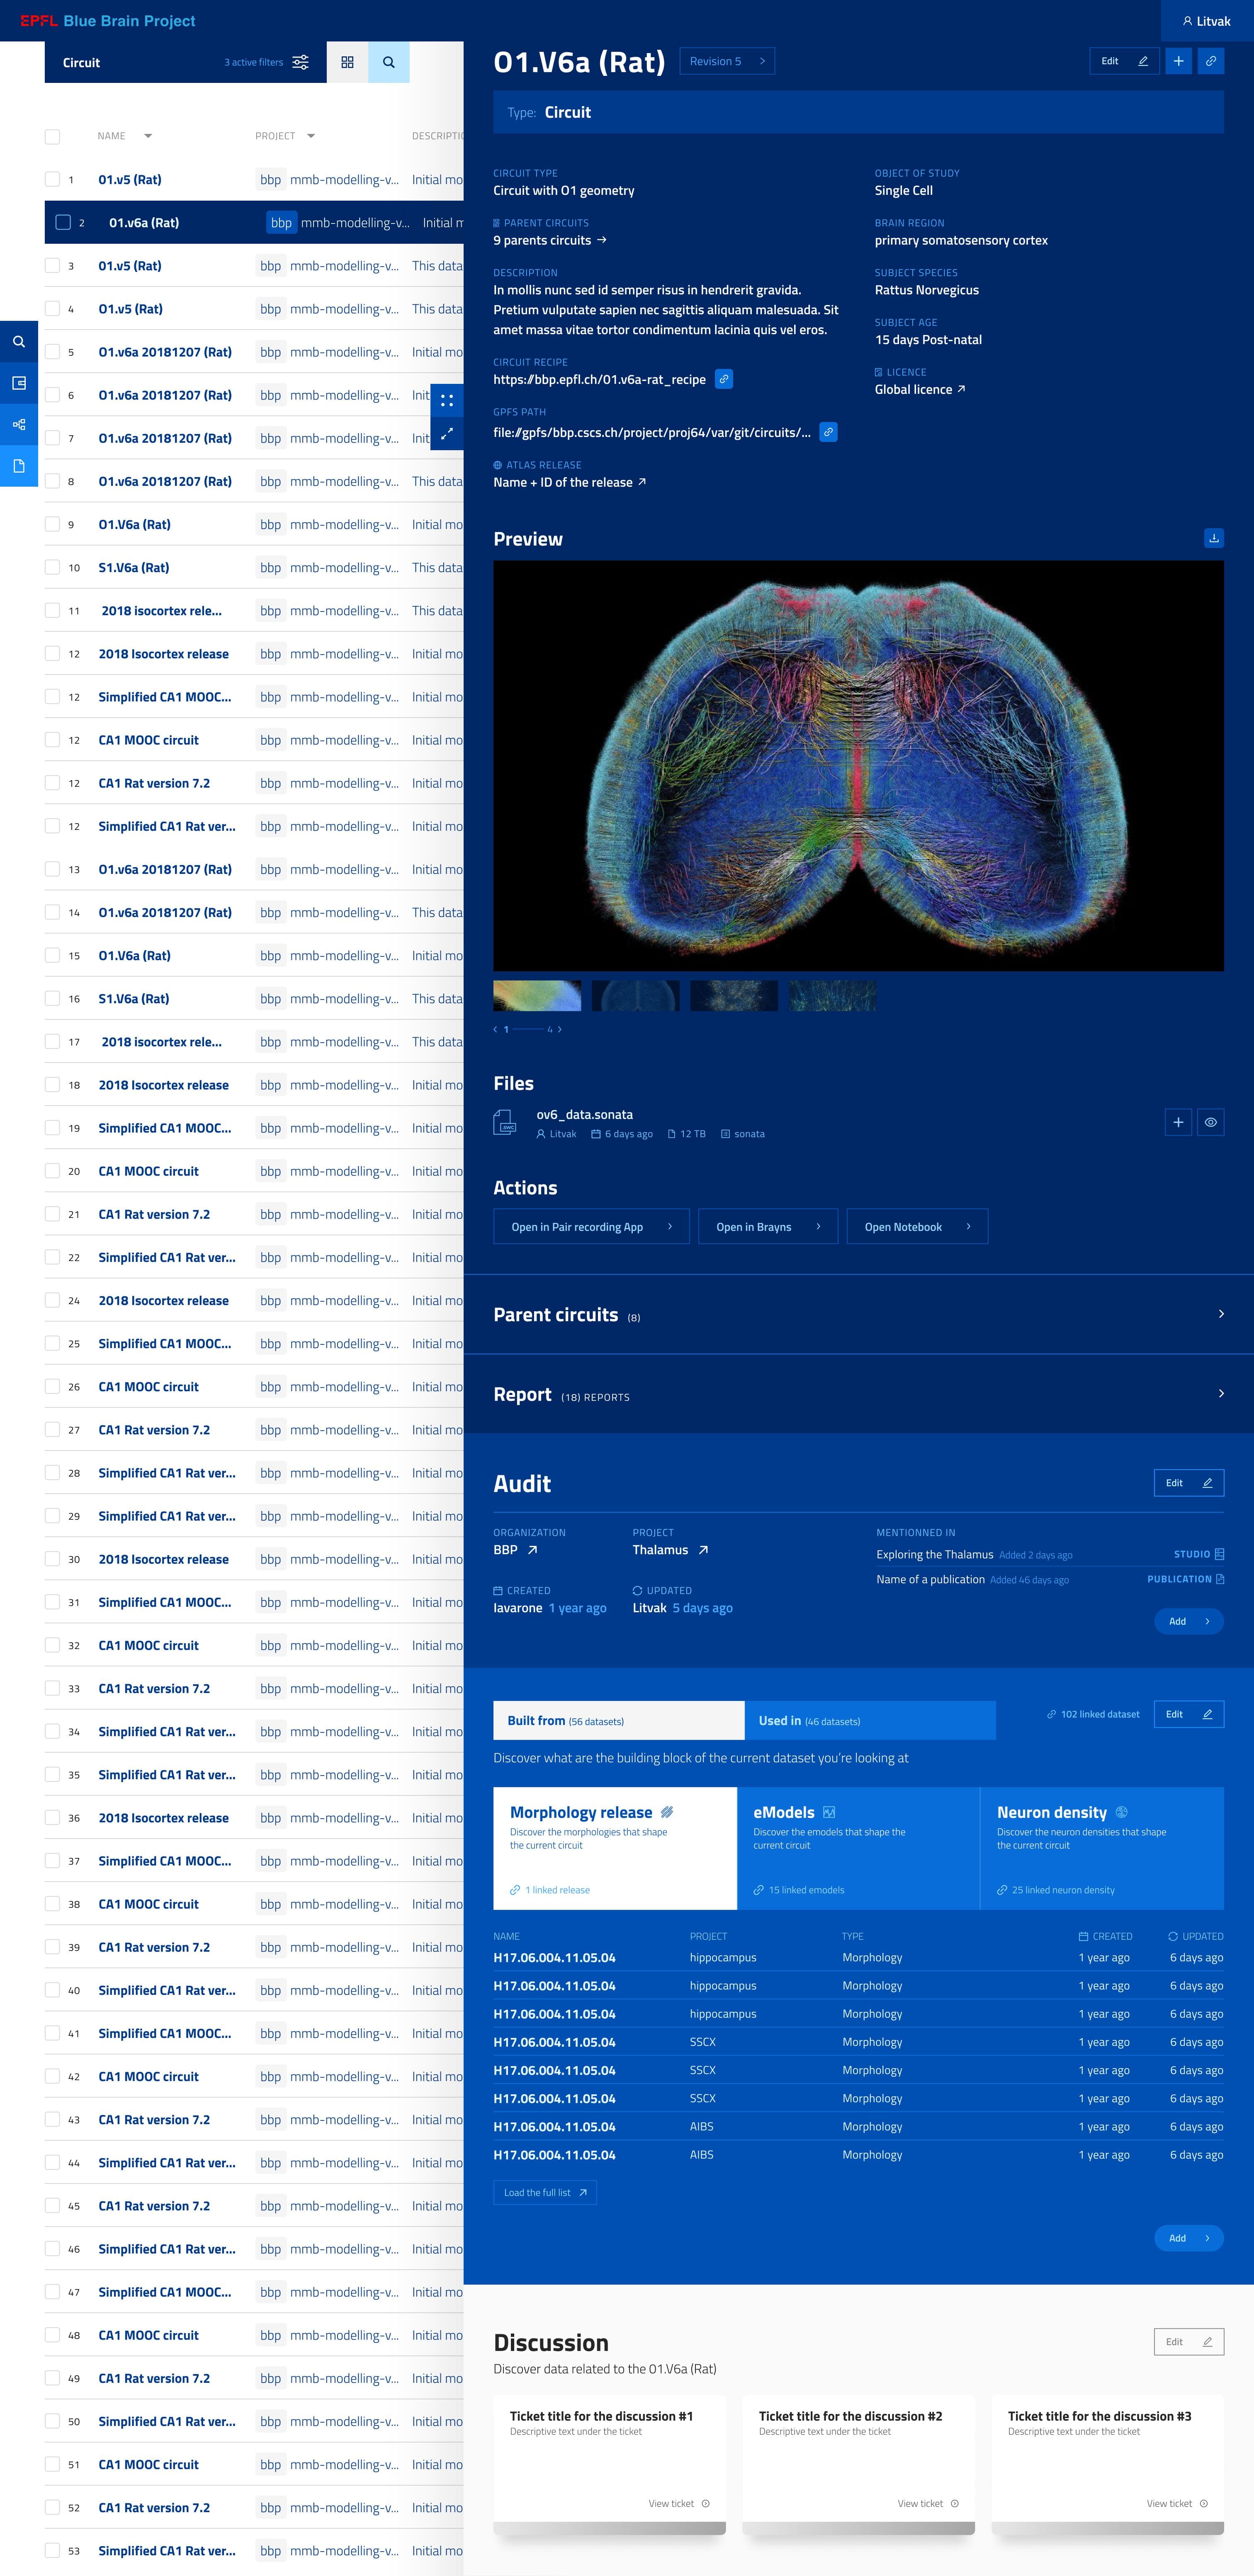
L’aperçu du circuit.
Les blocs « Built from » et « Used in » avec leurs jeux de données liés.
04
La valeur mesurable générée pour la recherche
Données consultées passées de 14 % à 94 %.
Plus de 2 600 chercheurs actifs par mois sur l’application web.
Plus de 12 000 rapports, 20 000 données expérimentales et 150 studios publiés.
Une proposition contestée est devenue une preuve de concept approuvée par quatre responsables d’équipe, validée sur des données réelles.
05
Mes apprentissages et mon niveau de maturité
J’aurais ajouté une console de curation des données, utilisée par l’équipe de curation du BBP, pour montrer le cycle de vie d’une donnée plutôt qu’une image figée. Les utilisateurs voulaient savoir quand une donnée avait été créée ou mise à jour, mais le temps et les personnes manquaient, donc je l’ai laissée de côté.
J’ai appris que les données d’usage tranchent mieux que les opinions : cinq ans de requêtes API et la recherche qualitative ont réglé un débat qu’un avis de designer n’aurait pas réglé.
Un point reste ouvert : la faisabilité du module de relations à l’échelle de millions de ressources, et sa mise en production.

