요약
게시된 데이터의 86%가 조회되지 않던 터미널 전용 접근에서, 데이터를 출처로 연결하는 그래픽 인터페이스로 바꾸어 94%의 데이터가 조회되게 했습니다.
게시된 데이터의 86%가 조회되지 않던 터미널 전용 접근에서, 데이터를 출처로 연결하는 그래픽 인터페이스로 바꾸어 94%의 데이터가 조회되게 했습니다.
게시된 데이터의 86%가 조회되지 않던 터미널 전용 접근에서, 데이터를 출처로 연결하는 그래픽 인터페이스로 바꾸어 94%의 데이터가 조회되게 했습니다.
프로토타입 먼저
저는 순수한 디자인 작업에 들어가기 전에, 가치 제안과 비즈니스 플랜을 검증하기 위해 이해관계자들이 프로토타입이나 POC를 만들도록 끊임없이 이끕니다.
Blue Brain Project, EPFL
2022 – 2024
프로덕트 디자인 리드, 프론트엔드 엔지니어
NISE 팀, 백엔드 엔지니어 3명, 전산 신경정보학 팀과 HPC 팀
조회된 데이터 14% → 94%
게시된 데이터의 86%는 한 번도 조회되지 않았습니다. 터미널과 SDK로만 접근할 수 있었고, 과학자들이 정작 원한 것은 데이터 사이의 연결을 보는 것이었습니다.
제품을 라이브러리 검색과 API 엔드포인트로 축소하자는 의견을 거절하고, 5년간의 사용 데이터와 정성 조사로 뒷받침한 뒤, 뉴런 20개 회로 테스트로 실현 가능성을 증명했습니다.
조회된 데이터 14% → 94%, 월 2,600명이 넘는 활성 연구자.
01
거의 아무도 열어 보지 않는 게시 데이터
Blue Brain Project에서 첫 사용 진단 결과, Fusion에 게시된 데이터의 86%가 한 번도 조회되지 않았습니다. SDK나 터미널로만 접근할 수 있었는데, 과학자들은 데이터 사이의 연결을 보고 싶어 했습니다. 내부에서는 제품을 검색과 API 엔드포인트로 줄이자는 의견도 있었습니다. 전체 플랫폼은 세 가지 반론에 부딪혔습니다. 비용, 낮게 평가된 우선순위, 데이터 품질입니다.
02
제가 관철하고, 협상하고, 거절한 것
일부는 제품을 라이브러리 검색과 터미널에 복사해 쓰는 API 엔드포인트로 줄이길 원했습니다. 저는 데이터를 구조화하고, 주석을 달고, 연결하고, 공유하는 진짜 플랫폼을 주장했습니다. 두세 차례 회의에서 과학자 인터뷰와 5년간의 API 요청 기록으로 입장을 뒷받침했고, 터미널은 거의 쓰이지 않았다는 것을 보여 주었습니다. 웹 앱에서 시뮬레이션을 실행하는 것도 거절했습니다. 매개변수와 시뮬레이션 전마다의 데이터 검증을 갖춘 별도의 애플리케이션이 필요했기 때문입니다.
03
기준점 없는 프로젝트 목록에서, 데이터 유형과 출처로 탐색하는 방식으로
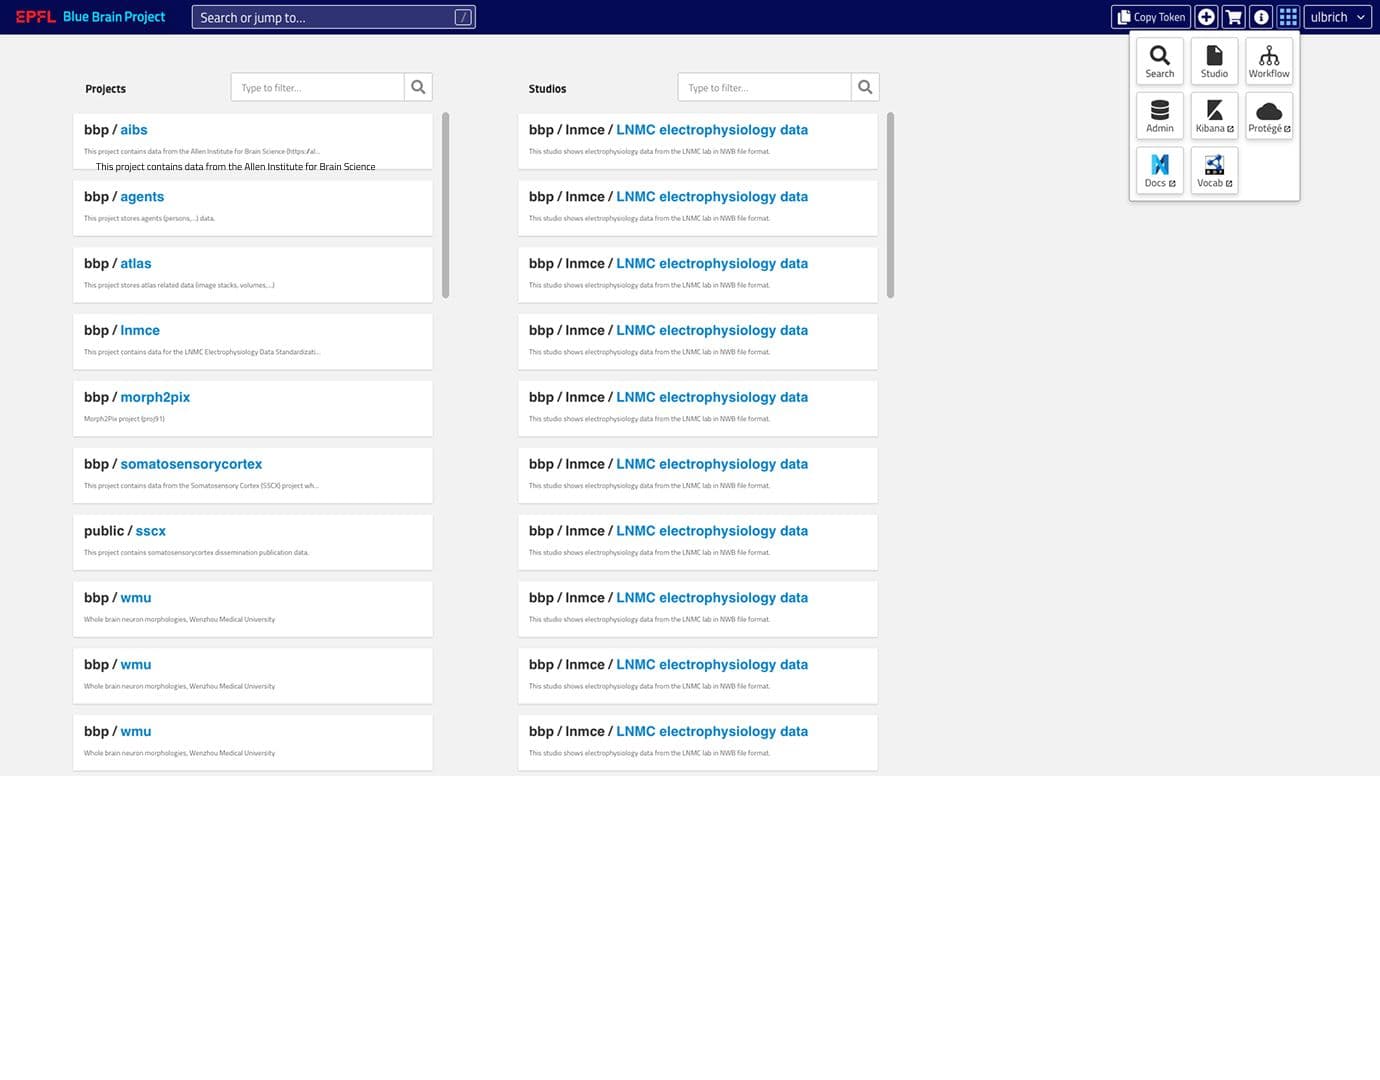
항목이 똑같이 반복되는 두 개의 긴 프로젝트·연구 목록.
흩어진 도구 메뉴(Search, Studio, Workflow, Admin, Kibana…).
데이터 유형(형태, 전기생리, 시뮬레이션…)별 검색과 데이터셋 수.
고정된 항목.
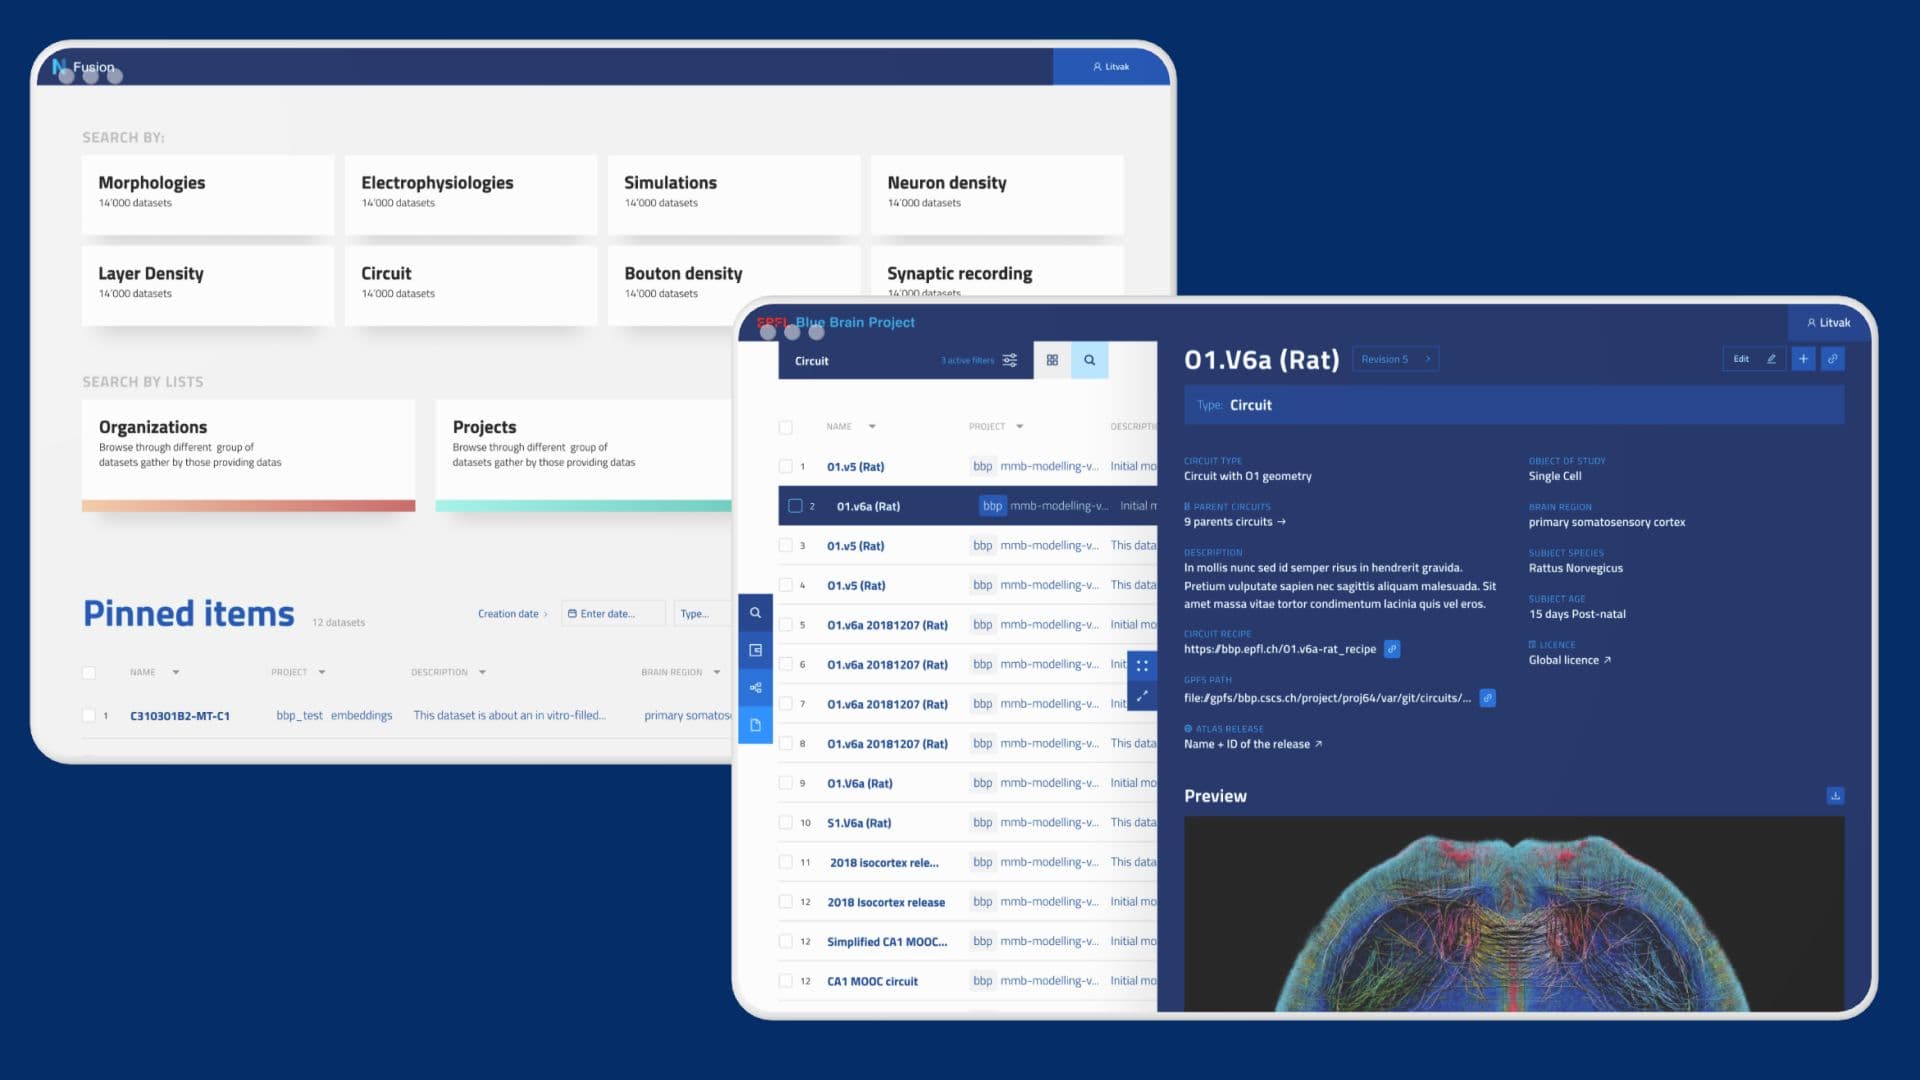
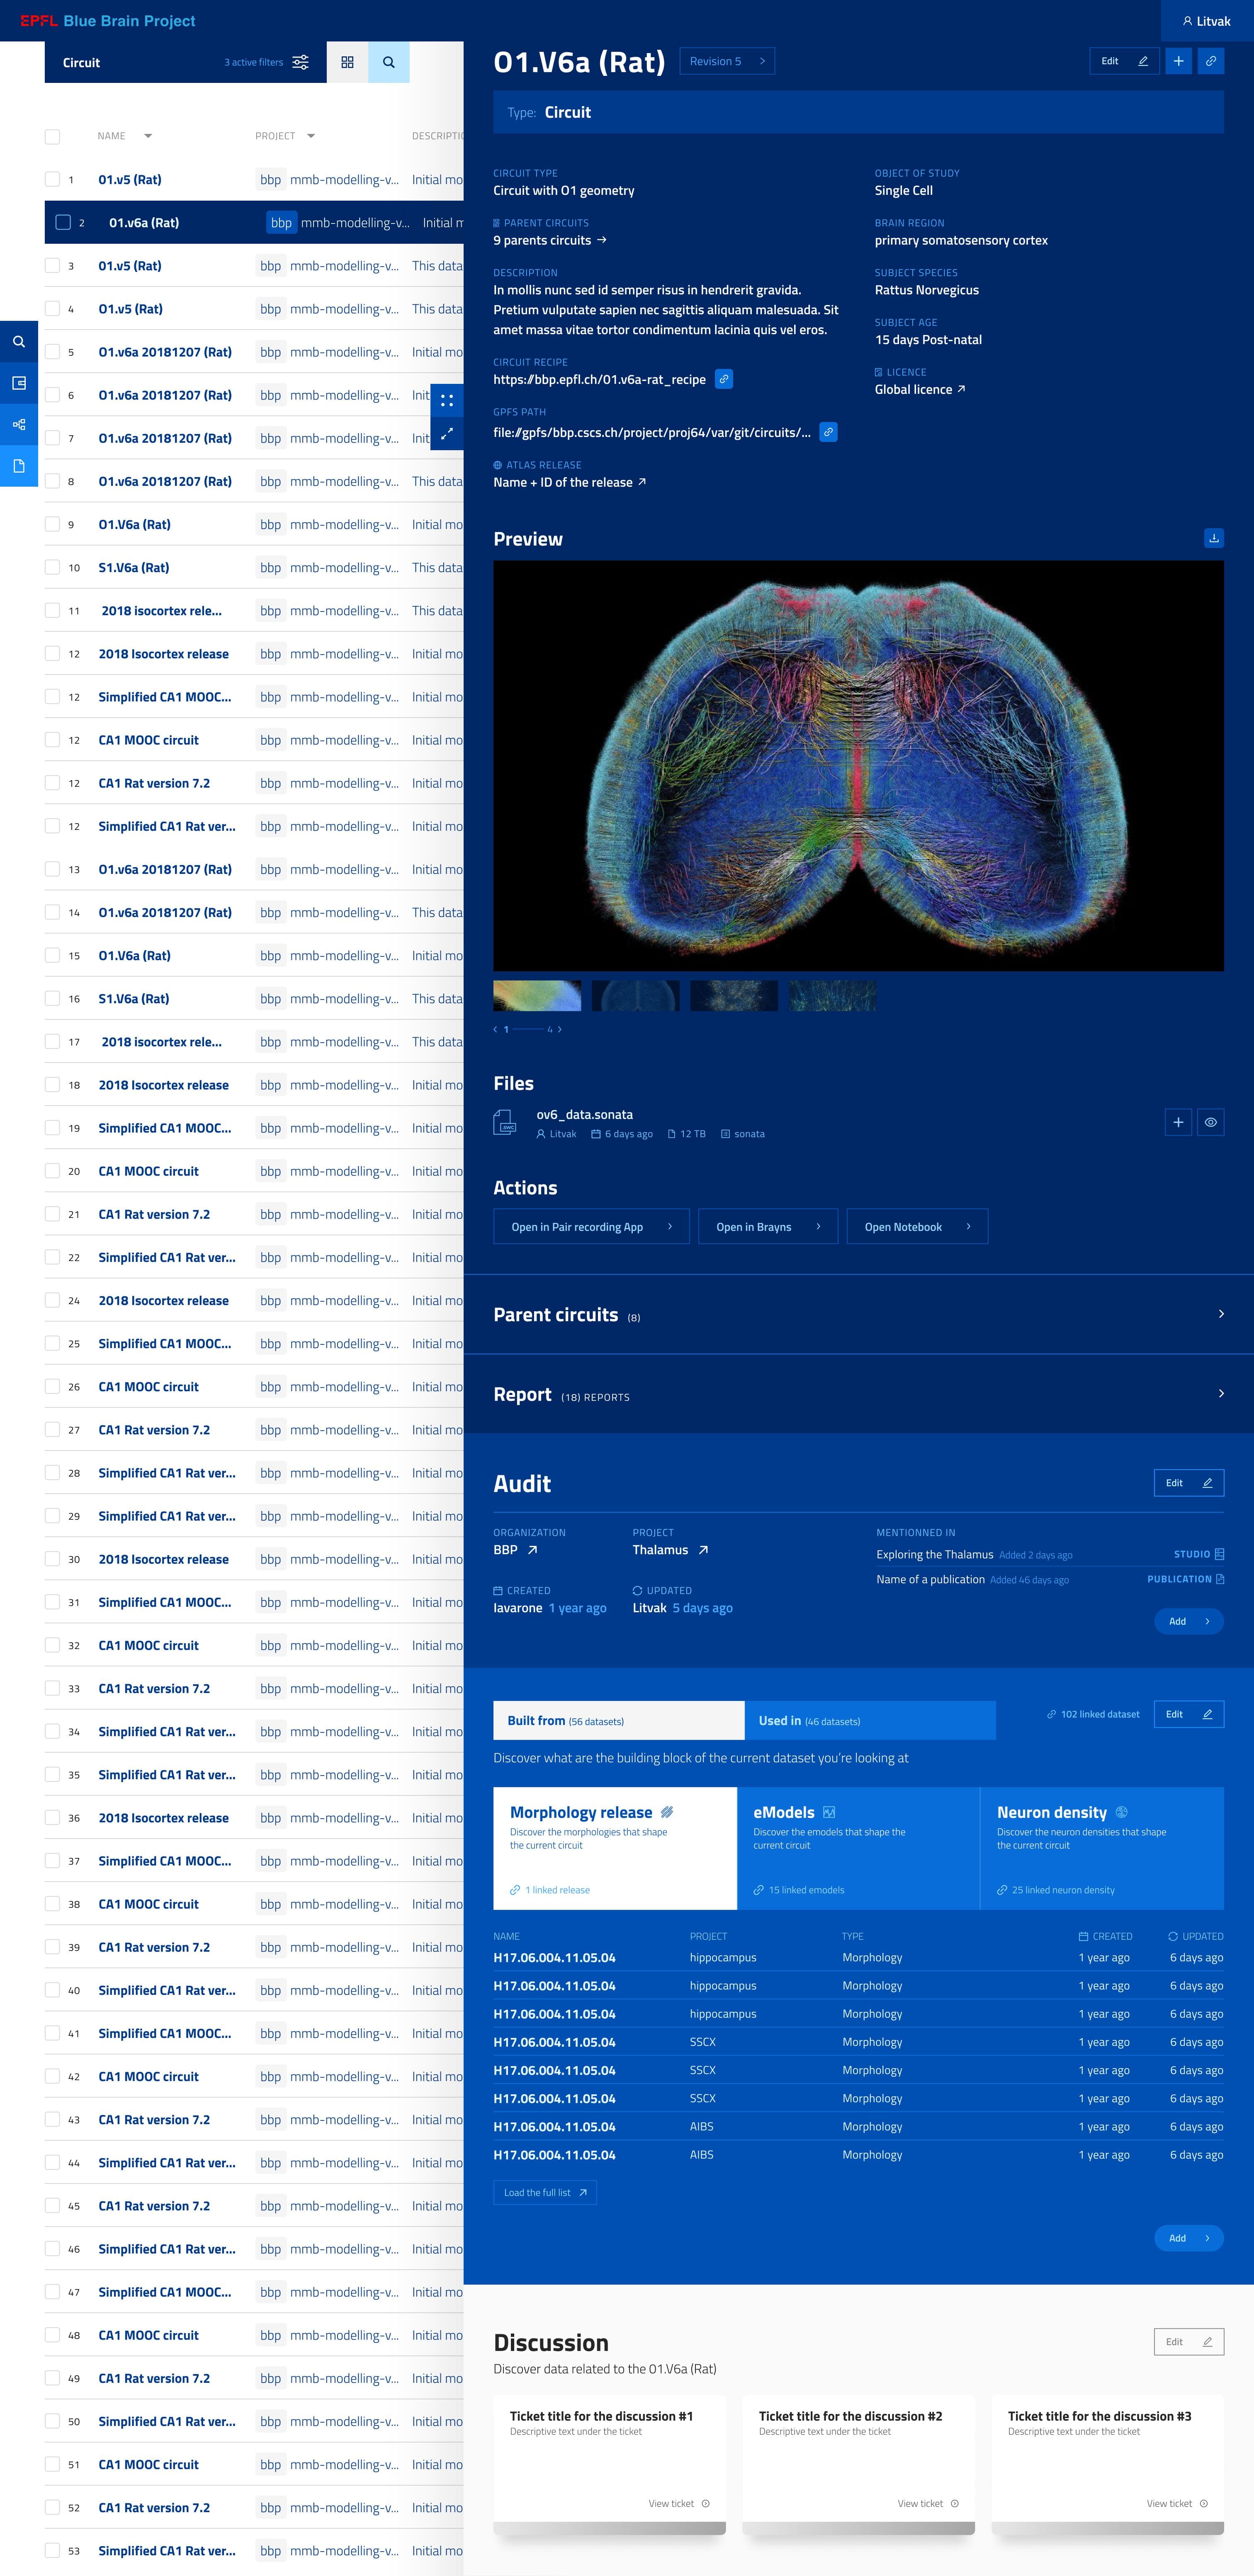
회로 미리보기.
연결된 데이터셋이 있는 “Built from”과 “Used in” 블록.
04
연구에 만들어 낸 측정 가능한 가치
조회된 데이터가 14%에서 94%로 증가.
웹 앱의 월간 활성 연구자 2,600명 이상.
12,000건 이상의 리포트, 20,000건의 실험 데이터, 150개의 스튜디오 게시.
논란이 되던 제안이 팀 리더 네 명의 승인을 받은 개념 증명이 되었고, 실제 데이터로 검증되었습니다.
05
배운 점과 현재의 성숙도
BBP 큐레이션 팀이 사용할 데이터 큐레이션 콘솔을 추가해, 정지된 이미지가 아니라 데이터의 생애 주기를 보여 주었을 것입니다. 사용자들은 데이터가 언제 만들어지고 갱신되었는지 알고 싶어 했지만 시간과 인력이 부족해 보류했습니다.
사용 데이터가 의견보다 더 잘 결론을 낸다는 것을 배웠습니다. 5년간의 API 요청과 정성 조사가 디자이너의 의견으로는 끝낼 수 없던 논쟁을 정리했습니다.
한 가지는 열려 있습니다. 수백만 개 리소스 규모에서 관계 모듈의 실현 가능성과 프로덕션 도입입니다.

